前編「まずはいろんなログを集めてみる」では、Hermesちゃんに「ログを調べて」と頼んだら、生ログを何度も取りに行ってしまい、大量のトークンを消し飛ばし、煽りを食らって紐づいているAIサービスのAPIレート制限にもぶち当たりました。AIは熱心だけれど、その熱心さに任せておくとログまで際限なく読みに行ってしまう。そこで、先に決定論的にプログラムで処理し、その結果をAIに見てもらうことにしました。
今回は、「なんちゃってSOC」の仕組みを少しずつ形にしていきます。まずは約9万件ほど溜まっていたログをSQLで集計し、総件数やホスト別・時間帯別などの集計結果を合わせて50行弱にまとめました。その集約データを別エージェントであるCodexちゃんに見てもらい、とりあえずそれらしくダッシュボードに並べさせてみます。これで「なんちゃってSOC」らしくなるのでしょうか。
もちろん、本格SOCを作りたいわけでもありません。「なんちゃってSOC」を回してみることで何が見え、人の仕事として何が残るのか。中小企業の担当者が通知を受けた後のことも考えながら、実測で分かったことと、まだ確かめられていないことを分けて見ていきます。
ログをSQLで集計し、結果をAIに渡す
大量のトークンを消し飛ばすという手痛い経験をしたので、今回はAIに生ログを自由に読ませるのをやめました。蓄積したログから対象をSQLで明確に切り出して、AIには生ログの取得や大量データの集計をできるだけさせない作戦です。
SQLで返させたのは、総件数、時間帯別、Syslogの重大度(Severity)別、ホスト別、認証失敗や秘密ファイル・管理画面をつつこうとするWebアクセスの分類別などです。今回の一次評価では、AIに渡す入力を、このようにSQLで集約したデータに絞ってみます。
集約データをCodexちゃんに見てもらう
次はCodexちゃんに、集約データから「人が確認しておくとよさそうな項目」を拾い、優先順位をつけて並べてもらいます。
実際にAIに渡してみると、うちの環境では認証失敗の多さや、秘密ファイル・管理画面をつつこうとしているように見えるWebアクセス、Syslogの重大度2(Critical、ログ送信元が付けた重大度)のイベント、時間帯による件数の変化などが、確認候補として並びました。ここでAIにインシデントの有無を判定してもらうわけではなく、次に人が確認する項目を整理してもらいます。
認証失敗が多いと分かったら、送信元が偏っているのか、認証成功と同じ時間帯に起きているのか、対象ホストは想定どおりかなどを確認していきます。こうした点は、別のログや運用記録を人が見ないと分かりません。秘密ファイルや管理画面をつつこうとするWebアクセスも、件数だけ見て判断せず、その後のアクセスが適切にブロックされているかなどを確認しておく必要がありそうです。
AIには、調査の取っ掛かりとして、観測された事実と、そこから考えられること、まだ分からないことを分けて書いてもらいました。なんでも「安全」か「危険」かの二択にされても、かえって困ります。
集計とAI評価を眺めるダッシュボード
レポートを毎回ファイルで開くのも、だんだん面倒になってきます。最新の状態と確認事項をひと目で見られたらよさそうです。そこでPythonで表示用データを作り、静的HTMLとSVGでダッシュボードを組んでみました。
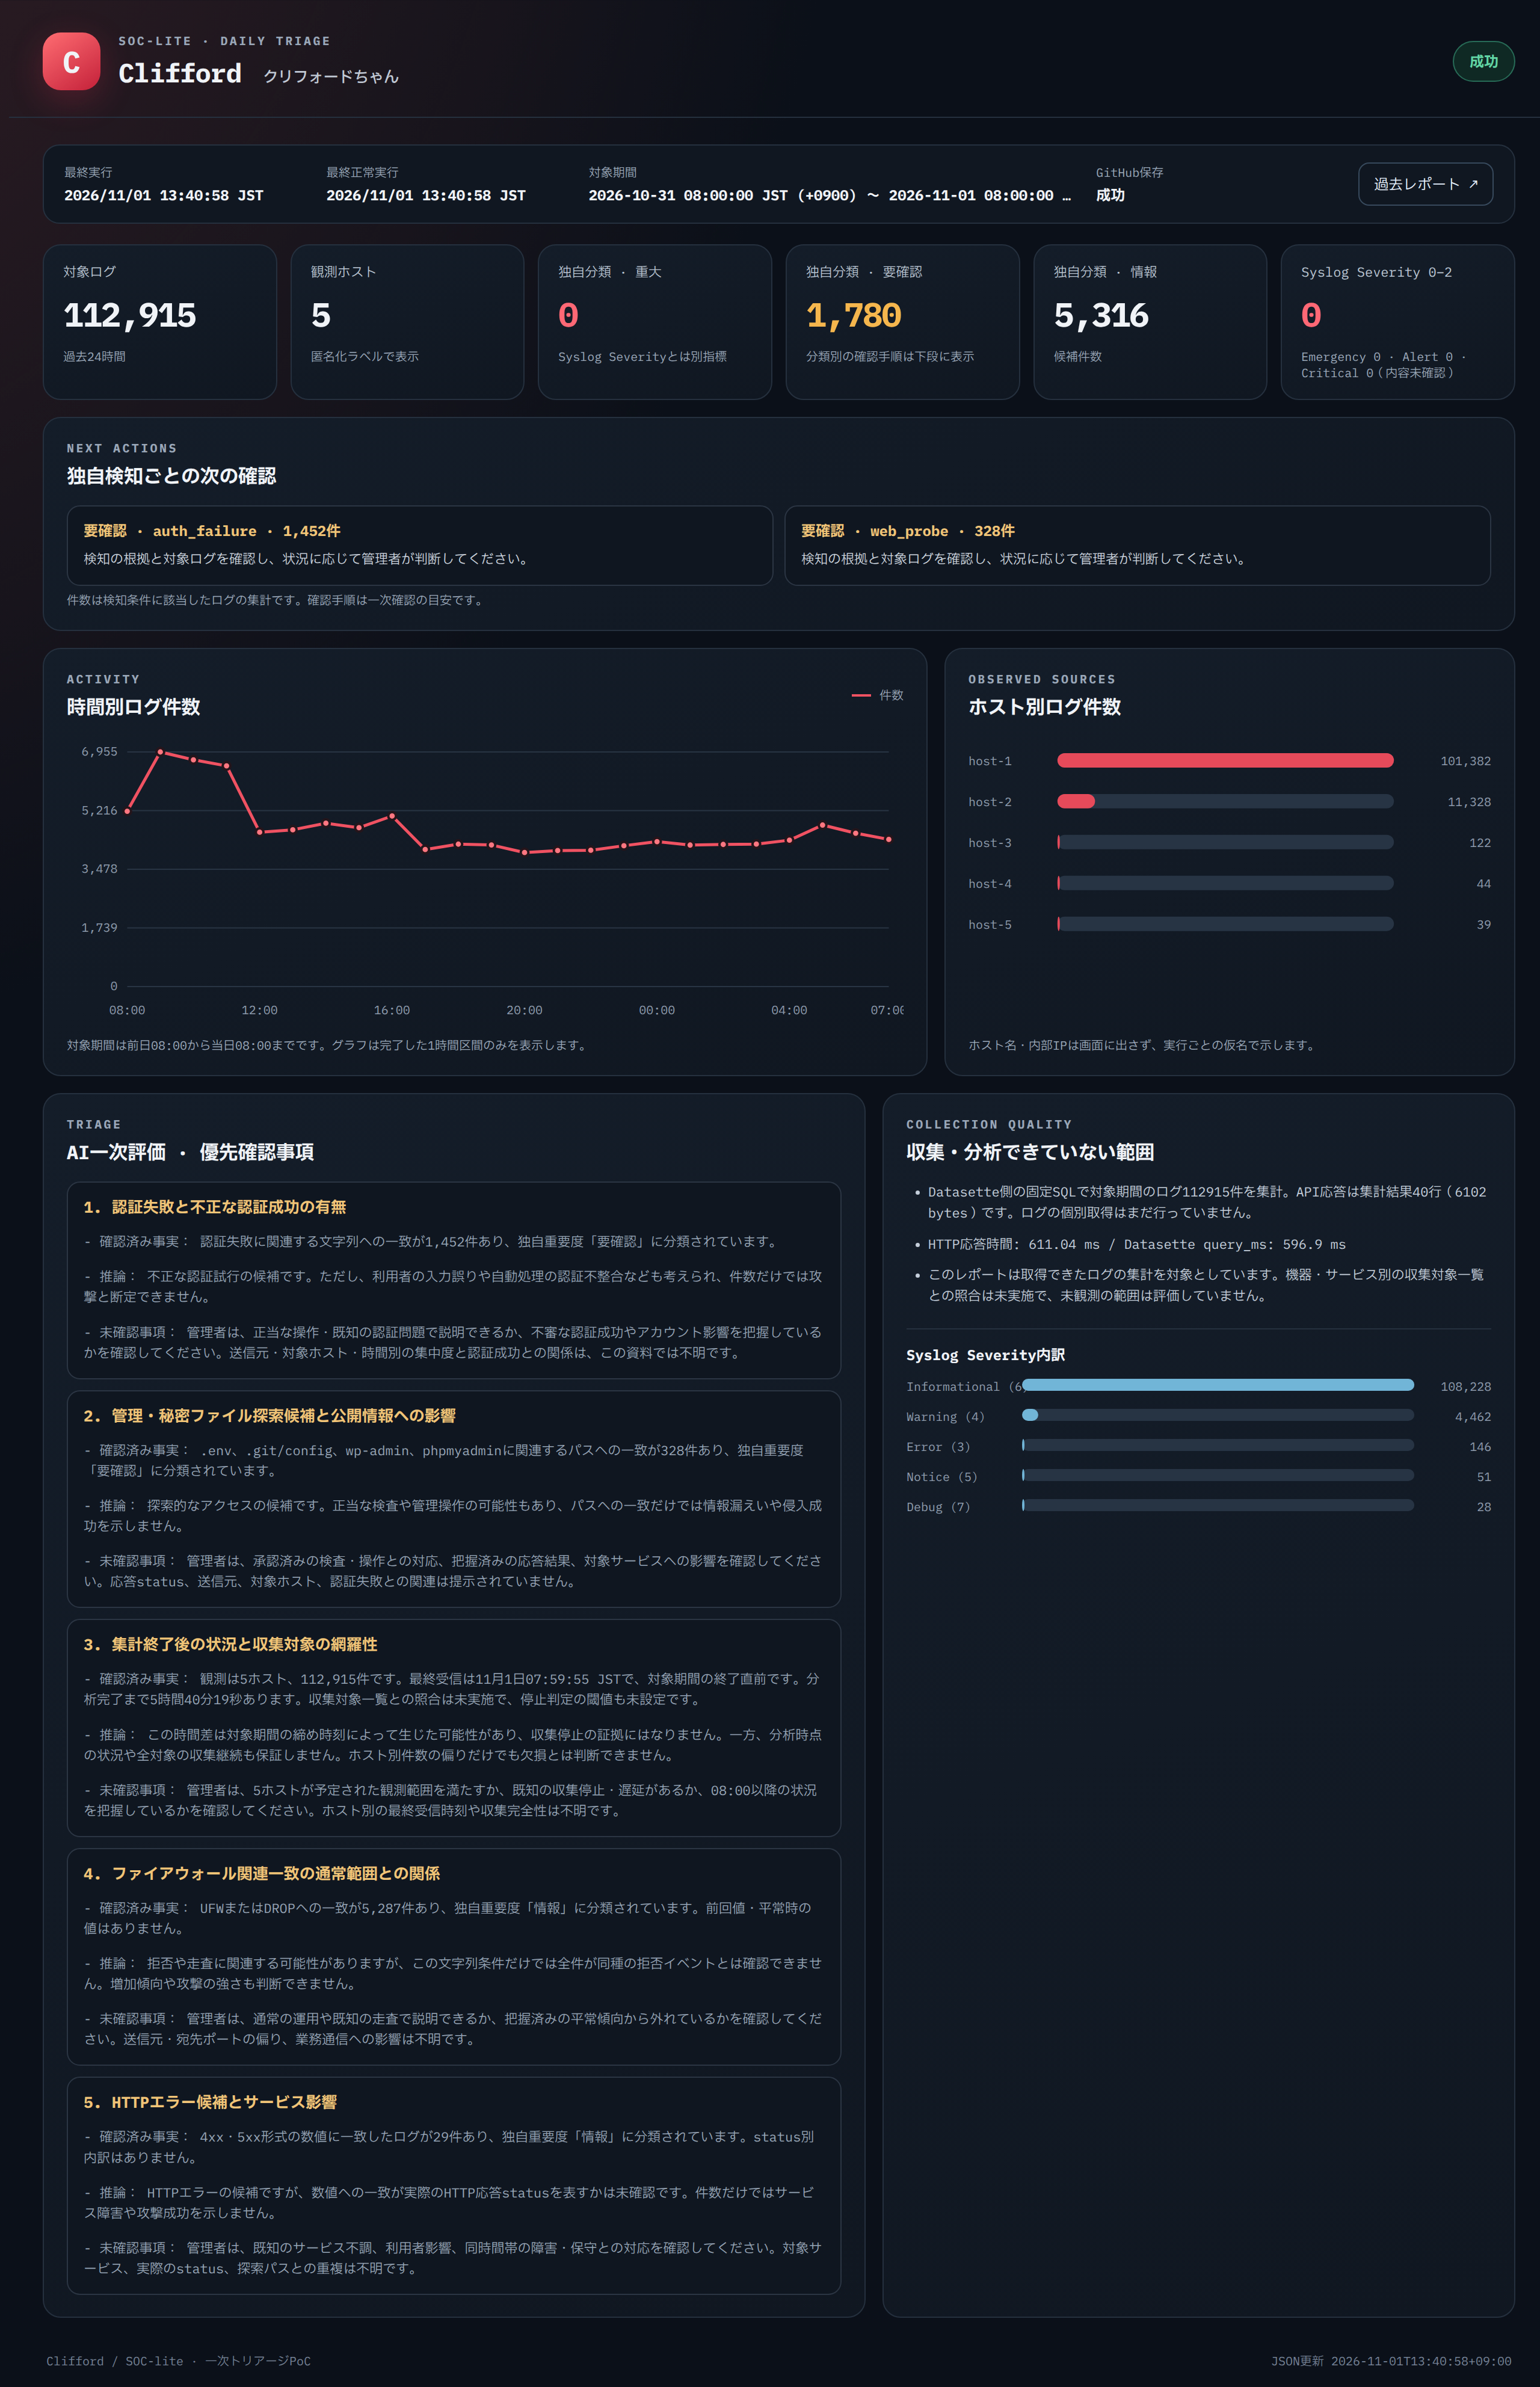
なお、掲載したダッシュボードは最初の約9万件の集計トライアルとは異なるタイミングで取得したもので、対象ログは約11万件になっています。
ダッシュボードには、最新の実行状態やAI一次評価、ログ件数の推移、Syslogの重大度、ホスト別集計、収集・分析できていない範囲や未確認事項、GitHubに残した過去レポートを並べてみました。とはいえ、これだけで実際に問題が起きているかどうかを判断できる段階ではありません。コメントもAIが生成したダミー文字列に近いものです。それでも、「独自重要度『要確認』に分類されています。」という一文を、どう深掘りすればわたしたちが知りたい情報に近づけられるのか。壁打ちしながらブラッシュアップしていくことに価値があると思っています。
クリフォードちゃんの仕事場
クリフォードちゃんは、SOC-liteの日次処理を動かす専用LXC環境につけた愛称です。AIモデルの名前ではありません。Proxmox上にDebian 13のUnprivileged LXCを作り、専用の非rootユーザーを作成します。Pythonで集計と日次処理をし、Codex CLIに一次評価を依頼させます。systemd timerで定期実行し、レポートはGitHubへ保存させます。Headscale経由でアクセスできるWebダッシュボードも用意しました。
前編で集め始めたログを土台に、固定SQLの集計、AIの一次評価、ダッシュボード、GitHubへの記録を足して、毎朝自動実行する構成につなぎました。部品を並べているうちに、「なんちゃってSOC」も少しずつそれらしくなってきました。名前は相変わらず、なんちゃってですが。
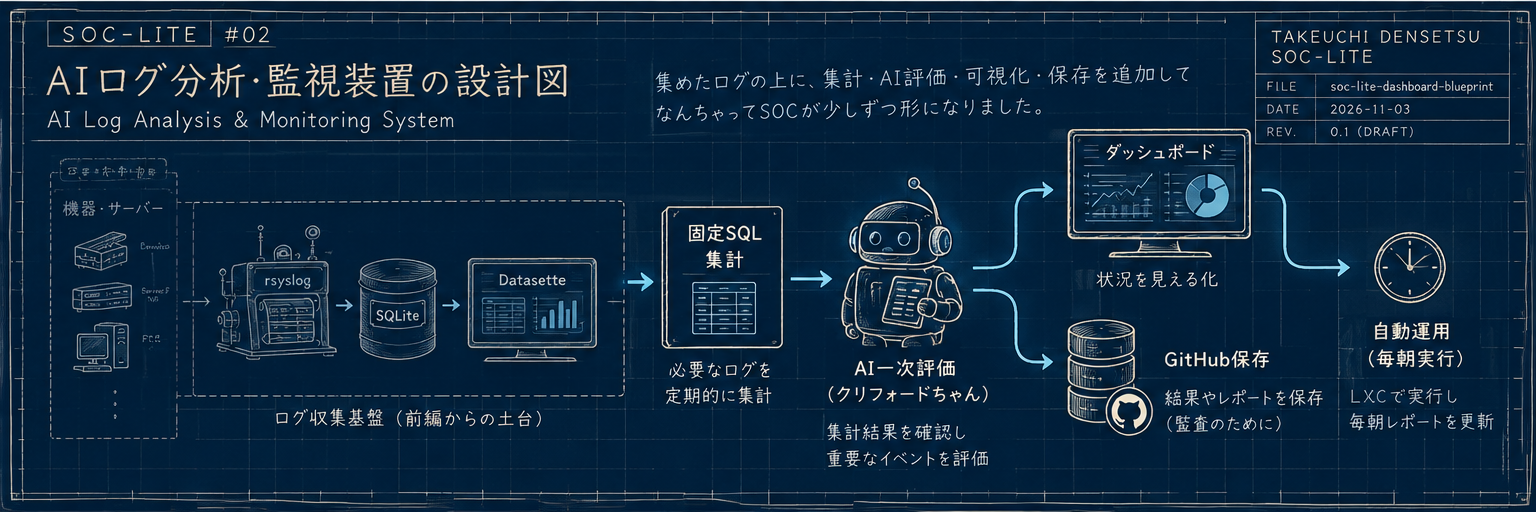
図では、処理の流れを分かりやすくするため、クリフォードちゃんをAI一次評価の位置に描いています。実際のクリフォードちゃんは日次処理を動かすLXC環境の愛称で、一次評価はCodex CLIに依頼します。
できるだけ制限したLXCコンテナで動かし、運用ユーザーにはroot権限を持たせず、プログラムを置く場所とレポートや状態を書き込む場所も分けています。Codex CLIは読み取り専用のsandboxで実行し、ログ収集基盤の設定変更やインシデント時の端末の隔離はできません。AIに任せるのは、集約データをもとに確認項目を整理するところまでです。
試行錯誤の末、最初は手で一度動かすだけだったものが、日次の分析、GitHubへのレポート保存、ダッシュボード更新を自動実行する構成までつながりました。
自動実行の設定ができたからといって、まだ何日も何か月も安定して動いた実績ができたわけではありません。これらはこれから確かめるべきところです。
使う技術を増やしすぎなかった
こういう用途でよく見かけるGrafanaやフロントエンドのフレームワークを追加する案も考えました。MarkdownベースのBIツールEvidenceも興味があったので調べています。分析画面を増やしたり、レポートを継続して比較したりするなら、専用ツールを導入する価値はありそうです。
でも今回まず見たかったのは、日次レポートを読みやすくして、実行状況と確認事項を表示することです。それなら、いつものPythonとMarkdown/JSONに静的HTML/SVGで事足りそうです。新しいDBやDocker、Node.js、Webフレームワークまで持ち込まなくても、今ほしいものは作れそうです。
セキュリティを監視する仕組みのために、新しい依存関係の脆弱性対応や更新・保守の仕事がどんどん増えたら、何をしているのか分からなくなってしまいます。今ある技術や運用資産を使い、依存を増やしすぎない。地味ですが、これも今回の大事な判断でした。
失敗はAIだけでは片づけられない
構築中には、CodexのsandboxからLAN内のDatasetteに接続できなかったり、何度もやったことありそうなSSHの公開鍵認証やknown_hostsでも止まったりしました。GitHub専用アカウントの権限や、無人実行時の認証も、手順を書いただけでは動くようになりません。小さな仕組みでも、周りの設定でつまずくものです。
AIはコードのたたき台を作ったり、失敗の原因候補を整理したりするのを手伝ってくれました。それでも、どの権限で動いているのか、データを意図した範囲に絞れているのか、エラーなのに「異常なし」と見せてしまわないかは、実際の環境で確かめます。AIが作ってくれたから大丈夫、とはいきません。動いたことを自分たちで確かめるところまでが作業でした。
自作して見えてきたSOCとMDRの難しさ
こうしてできた「なんちゃってSOC」は、ログを集計して、AIに確認の優先順位を提案してもらい、定期的にレポートっぽいものを残すところまではできるようになりました。何かを自動で止めたり、端末を隔離したりする仕組みではありません。専門家が運用するMDRサービスの代わりにもなりません。
作ってみて、SOCの仕事はひと続きに見えても、いくつもの段階に分かれているのだと気づきました。
- ログを集める。
- 定義した条件や傾向から異常の候補を見つける。
- それが本当に問題なのか、周辺情報と合わせて判断する。
- 必要な対応を決め、実行する。
- 誤検知だった場合の説明や、隔離解除、復旧まで責任を持つ。
段階ごとに必要な情報も、権限も、経験も違います。誤検知で端末が隔離されたとき、解除を判断する人と実行できる権限がなければ困ります。通知が来ても、兼任担当者が誰に連絡し、何を確認し、業務への影響をどう説明するのか分からなければ、結局そこで立ち止まってしまいます。
だから、MDRを選ぶときには「監視しています」「通知します」の先も聞いておきたい。誰が分析し、誰が対応し、どこまで責任を持つのか。端末を隔離する判断と解除、夜間休日の連絡、誤検知だったときの扱い、利用する側に残る作業。契約する前に、ひとつずつ確認したいと思いました。
わたしたちの「なんちゃってSOC」は、ログを見る仕事の入口を少しだけ体験させてくれました。作ってみても、AIに見てもらっても、通知の先には人がいます。その人が何を受け取り、どう動けるのか。MDRを勧める前に確かめたいことが、前編を始めたときより少し具体的になりました。
数値は特定時点のPoC実測例です。検知の網羅性、分析精度、稼働率、対応時間や復旧を保証するものではありません。収集できていないログや、設定した条件に当てはまらない事象は評価できません。