中小企業のお客さんから、EDRやMDRについて具体的な質問や相談を受ける機会が増えてきました。製品の機能や検知率などの機能要件を調べるのはもちろん大事です。ただ、わたしたちが気になったのは、もう少し運用寄りのことでした。
アラートが鳴ったら、誰が見て、何を判断し、どこまで動いてくれるのだろう。サービスの説明を読んでも、事故の当日に誰が何をするのかが、すっと頭に入ってこないことがありました。
「だったら、SOCがやっていることの一部を、手元で試してみよう。今ならAIにも手伝ってもらえるし」
そんな軽い思いつきで、わたしたちの「なんちゃってSOC」づくりが始まりました。前編では、まずログを集めて眺め、AIに生ログを読ませようとしてつまずくまでを紹介します。
ちなみに、わたしたちは用途に応じて複数のAIエージェントを使い分け、愛称を付けて呼んでいます。技術相談や方針検討はChatGPTの「チャッピーちゃん」、プログラムの作成や修正はCodexの「Codexちゃん」、Slack経由の日常作業や自動化はHermes Agentの「Hermesちゃん」です。今回、ログ分析を頼んだのはHermesちゃんでした。
MDRを勧める前に、SOCの仕事を知りたくなった
EDRは、端末上の挙動を監視して、怪しい動きを検知する仕組みです。MDRは、その検知を人や運用チームが分析し、通知や対応支援につなげるサービスとして説明されます。実際にどこまで含まれるかはサービスごとに違うので、名前だけで判断はできません。
調べていると、わたしたちには次の疑問が残りました。
- 24時間監視とは、監視・分析・通知・隔離・復旧支援のどこまでなのか。
- 誤検知で端末が隔離されたとき、誰が解除を判断するのか。
- 通知を受け取った兼任担当者は、最初に何を確認すればよいのか。
- 販売会社とSOC運用会社が別なら、どこからどこまでが誰の責任なのか。
- 端末台数が少ない会社でも、現実的に利用できるのか。
- サービスとして説明されている対応範囲と費用感は、どう結びついているのか。どこまでが標準で、何が追加対応なのか。
複数のサービスに加え、公的な制度や関連情報の掲載内容も参考に調べ、見込み顧客として、また支援先への紹介を検討する立場から関係先へ問い合わせました。しかし、公開情報と今回の問い合わせだけでは、実際の運用や対応範囲を十分に把握できない場面がありました。確認をお願いした事項の中には、この記事を書いている時点で回答を確認できていないものもあります。
もちろん、通常の問い合わせと、契約に基づく緊急時のインシデント対応は別のものです。今回の問い合わせ状況から、実際の事故対応力を評価することはできません。ただ、調べる側としては、緊急時の連絡窓口や判断・対応の責任分担について、契約前に具体的に確認しておきたいと感じました。制度全体や個別サービスの品質を決めつけたいのではなく、説明を読んでも、実際に事故が起きたとき、誰が何を判断し、どこまで対応するのかが見えにくかった。
そして、わたしたちに助言を求める経営層が知りたいのも、まさにこの点ではないかと思います。
ならば、SOCの仕事の一部を自分たちで体験してみよう。AIに手伝ってもらえば、「なんちゃってSOC」くらい作れるんじゃないか。名前からして、すでに本格派ではありません。
SOCは何を見ているのか(よくわかっていない人の想像)
SOCはSecurity Operations Centerの略で、セキュリティ上の出来事を継続的に見て、調査や対応につなげる役割を指します。ログを集めるだけでは終わりません。対象のログを見て、いつもと違う動きを見つけ、誤検知かもしれない可能性も含めて根拠を確認し、担当者へ伝えます。
そこで「ログを集めてみる」ところから始めました。家や仕事場の機器からログが届いていれば、まずは眺められる形にできそうです。既存の仕組みを使えば、いきなり大きなSIEM製品を持ち込まずに済みます。
まずはいろんなログを集めて、見られるようにする
土台にしたのは、既存のProxmox環境です。ログ収集専用のLXCコンテナを新たに用意し、そこにログ収集用のrsyslogサーバーを構築しました。収集されたログをSQLiteへ取り込み、Datasetteというコンポーネントを利用してブラウザーから随時参照できる流れを作ってみました。
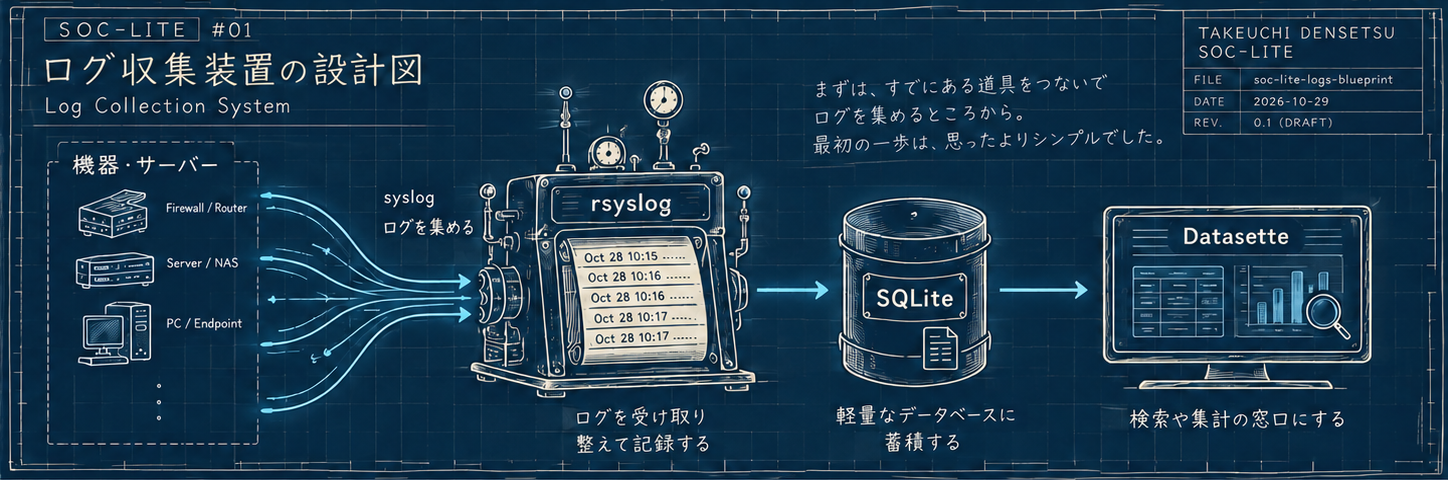
rsyslogを受け口にして、SQLiteをログの蓄積場所にし、Datasetteが検索や集計の窓口になってくれました。DatasetteはAPI経由でデータを参照できるため、人がブラウザーで見るだけでなく、AIがデータを見るための入口にもなってくれる優秀なコンポーネントのようです。まずはありものの道具を組み合わせてみただけ。AIと壁打ちをしながら、AIコーディングエージェントにも構築を手伝ってもらうと、土台づくりはあっという間でした。
もちろん、ログが集まることと、問題を見つけられることは別です。ログの量や内容は機器によって違いますし、そもそも必要なログが届いているかも確認しなければなりません。それでも、ばらばらのログを同じ場所から見られるようになったことで、ふと思ってしまいました。
「これをAIに読んでもらうだけで、何が起きているかをAIが教えてくれるのでは?」
何気なくAIに「ログを調べて」と頼んだら
最初はHermesちゃんに調査を任せてみました。ところが、AIに「ログを調べて」とだけ頼むと、どの期間を、何件まで、どんな粒度で調べるかを細かく制御するのが難しい。実際の試行では、なぜか生ログを何度も無駄に取得する形になり、ログの蓄積を始めて間もない段階でさえ、大量のトークンを消し飛ばしてしまいました。さらに、AIエージェントに紐づけているAIサービスのAPIレート制限にもぶつかってしまいました。
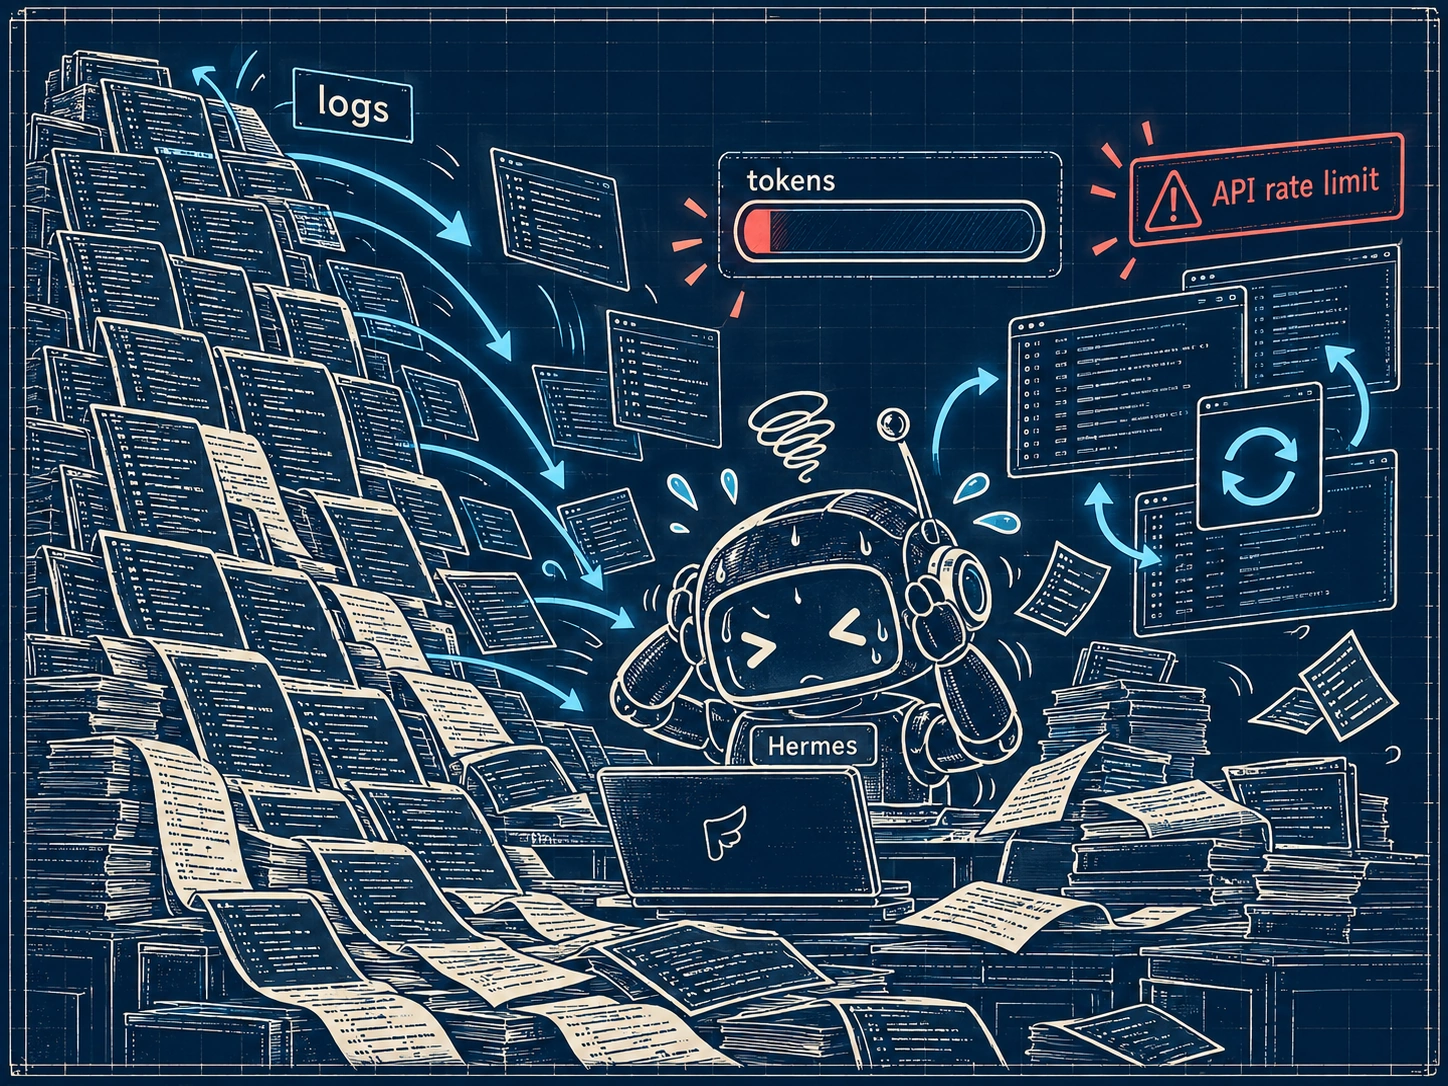
AIは熱心です。熱心さと効率は、ときどき別の方向を向きます。調べる範囲をエージェントの気配りだけに任せると、ログが多いほど「もう少し見れば分かるかも」と取得が膨らみかねません。
生ログにはホスト名やアカウント、接続元など、取り扱いに注意が必要な情報も含まれます。量の問題に加え、AIに扱わせる情報の範囲を把握し、必要以上の内容を渡さないことも大切です。何を見せたかを説明できる状態にしておきたいと思いました。
このときに、AI関連に無駄にお金を使って得た大事な教訓を、すっかり忘れていました。
「決定論で決まるものに推論のトークンを使うのは富豪のすること」
集計のように答えが一意に決まる処理までAIに任せる必要はありません。
ここで方針を変えました。AIにログを大量に読ませるのではなく、プログラム側で対象期間と取得量を決め、先に集計してからAIに評価してもらおう。つまり、データを絞る仕事は決められたプログラムに任せ、AIには集計値を読んで意味や優先順位を考えてもらう形です。
次回は、集計してからAIに評価してもらう
AIにログを見せる前に、何をどれだけ渡すかを決めておく必要がある。今回の試行で、まずそこに気づきました。ログを集めること、異常を見つけること、その出来事が本当に問題か判断することは、それぞれ別の仕事です。AIに任せれば一気に解決、とはいきませんでした。
後編では、固定したSQLで直近24時間のログを集計し、約9万件を41行にまとめます。その値をCodexちゃんに評価してもらい、ダッシュボードや日次処理を担うクリフォードちゃんへつなげます。
これは個人・社内環境で試したSOCもどきの体験記です。MDR/SOCサービスの性能評価ではなく、本番監視やインシデント対応の代わりになるものでもありません。